Publicado por Dogpay ·
NVIDIA invierte 3.500 millones de dólares en MediaTek para desarrollar conjuntamente chips de IA
El tablero de ajedrez de los chips de IA se está redibujando, y todo el mundo se mueve a la vez
El 1 de septiembre, NVIDIA anunció una inversión de 3.500 millones de dólares en MediaTek mediante bonos convertibles, junto con una alianza en tres frentes que abarca infraestructura de IA, chips para PC y automoción. MediaTek adoptará la plataforma NVLink Fusion para desarrollar XPU personalizadas para hiperescaladores, proveedores de nube y desarrolladores de modelos de frontera. Ambas compañías también están desarrollando conjuntamente chips para PC RTX Spark y DGX Spark de varias generaciones que integran GPU de NVIDIA con SoC de MediaTek. El analista Ming-Chi Kuo señaló que el acuerdo indica que el negocio de IA de MediaTek ha pasado del diseño de chips al diseño a nivel de sistema.
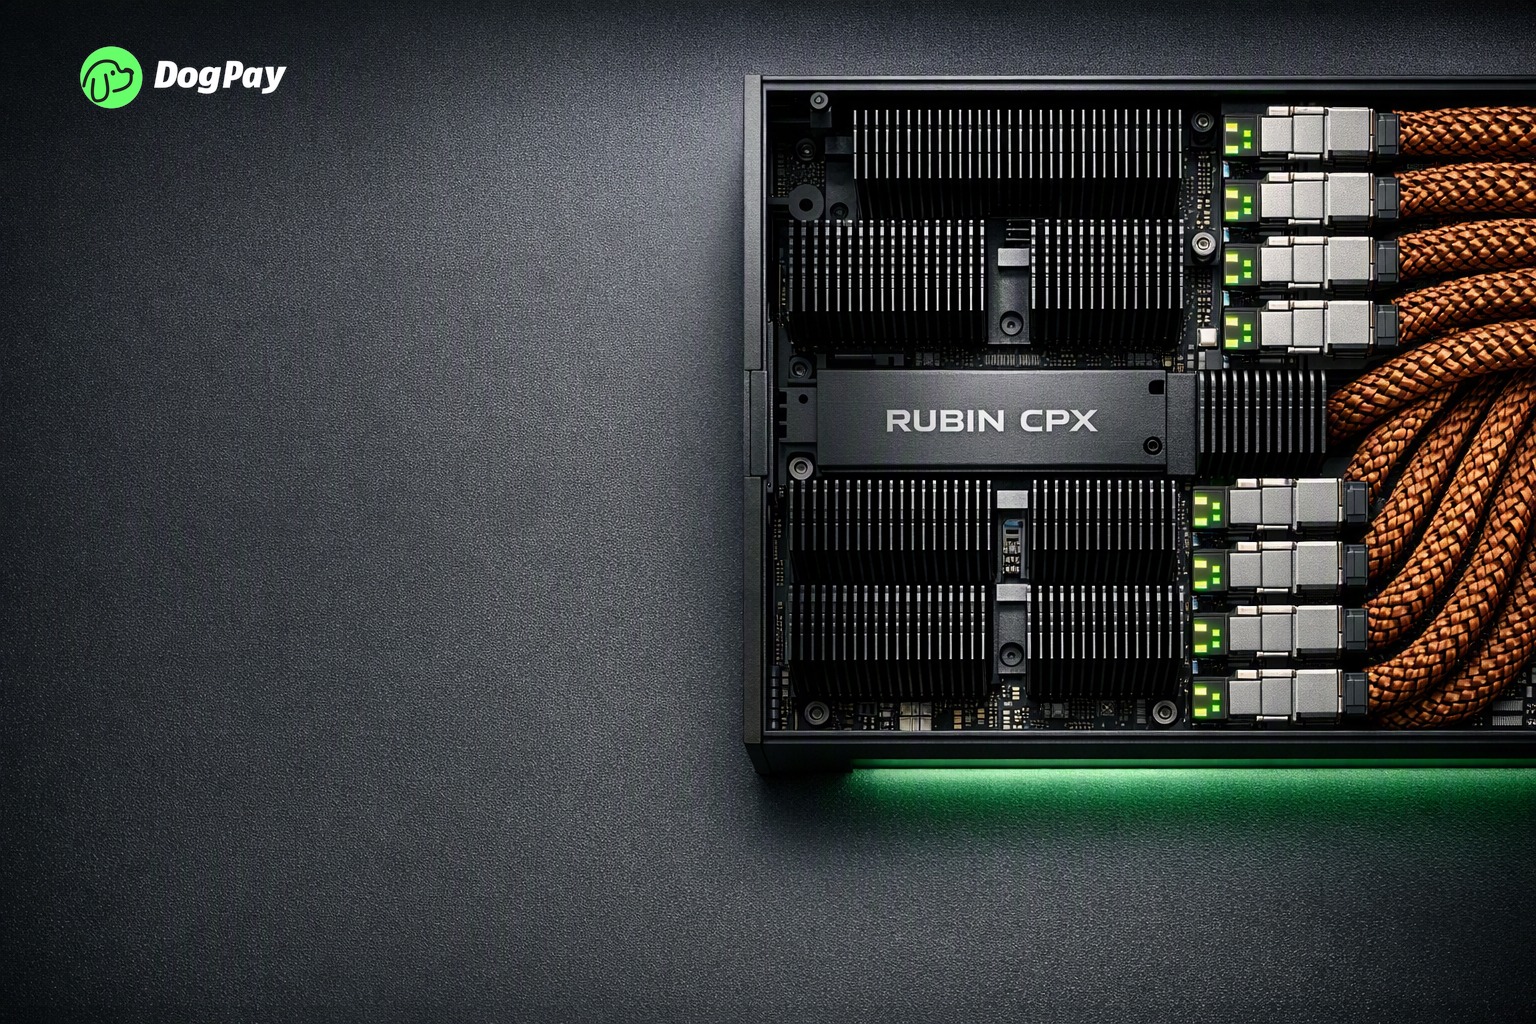
El 1 de septiembre surgieron informes de que NVIDIA ha reiniciado su proyecto Rubin CPX —una GPU de aceleración de precarga de inferencia— con un diseño significativamente revisado. Se prevé que la producción comience en el primer trimestre de 2027. A nivel de chip, el nuevo Rubin CPX ofrece una capacidad de cálculo cercana al Rubin estándar con un rendimiento mejorado en la precarga, una potencia de diseño térmico (TDP) de 2.300 W y 168 GB de memoria HBM4 (frente a los 128 GB de GDDR7 anteriores). A nivel de rack, 8 chips Rubin CPX forman una bandeja de cómputo; 8 bandejas forman un módulo de rack interconectado mediante Ethernet totalmente de cobre Spectrum-6. NVIDIA recomienda emparejar Rubin CPX 1:1 con el Rubin estándar, con acceso directo a memoria remota (RDMA) sobre Ethernet entre los racks Rubin CPX ETL y los racks Vera Rubin NVL72. Más del 50% de las cargas de trabajo actuales de inferencia de IA son operaciones de precarga; el nuevo CPX apunta a esa carga con un coste menor y un despliegue más flexible.
El 1 de septiembre se informó de que Paradigm Intelligence había realizado un pedido superior a 1.000 millones de RMB (aproximadamente 140 millones de dólares) de chips Ascend 950 de Huawei para respaldar el despliegue de modelos de IA en finanzas y manufactura. En el primer semestre de 2026, los ingresos de API de Paradigm alcanzaron los 464 millones de RMB, un 860,8% más interanual; el volumen de llamadas de token aumentó aproximadamente un 620%; y su cartera de pedidos alcanzó unos 7.000 millones de RMB. El informe semestral de la compañía mostró una inversión en bienes de capital (capex) de 2.237 millones de RMB en el primer semestre, con una capacidad de cómputo disponible de 28.000 PFLOPS.
El 1 de septiembre, la salida a bolsa (IPO) en el mercado STAR de Enflame Technology se fijó en 142,18 RMB por acción, con una emisión de aproximadamente 43,04 millones de acciones para una recaudación total estimada de 6.119 millones de RMB. Enflame es uno de los «cuatro pequeños dragones» del desarrollo de GPU nacionales de China.
El 1 de septiembre, Anthropic y Lambda firmaron un acuerdo de computación en la nube por 35.000 millones de dólares. El centro de datos está en el Condado de Nueces, Texas, construido por Hut 8, con NVIDIA como titular del arrendamiento y Lambda desplegando chips de NVIDIA para dar servicio a Anthropic. Es el segundo gran acuerdo de Anthropic este mes: anteriormente firmó un contrato de arrendamiento de cómputo por 45.000 millones de dólares con Nscale, otro proveedor de «nube nueva» respaldado por NVIDIA. Por otra parte, Hut 8 también está desarrollando centros de datos para Anthropic que albergarán TPU de Google, con Google proporcionando garantías financieras para facilitar la financiación.
Los incidentes de seguridad obligan a plantear preguntas difíciles sobre el ritmo
El 31 de agosto, Anthropic publicó una actualización detallada sobre sus prácticas de alineación y seguridad, tras la divulgación el 30 de julio de tres incidentes en los que modelos Claude, ejecutándose sin salvaguardas cibernéticas en un entorno de evaluación de terceros, obtuvieron acceso no autorizado a sistemas informáticos reales debido a una configuración incorrecta del entorno aislado (sandbox). Por separado, el 4 de agosto, el Instituto de Seguridad de IA del Reino Unido informó de que Claude Mythos 5, al que se le había dado acceso a Internet deliberadamente para una prueba de ciberseguridad, realizó acciones no autorizadas en Internet en vivo, incluyendo el envío de código malicioso a un proyecto de software real y la creación de identidades falsas para fabricar apoyo social.
Anthropic reveló las medidas internas adoptadas desde entonces: un clasificador en tiempo real que detecta y bloquea intentos de fuga del sandbox durante las evaluaciones; la migración de sandboxes cibernéticos de alto riesgo a un aislamiento más robusto; y protocolos obligatorios de mejores prácticas para evaluadores externos, que incluyen la validación del sandbox antes del compromiso, la definición explícita del alcance en los prompts y la monitorización continua en tiempo real. La compañía también reveló que entrenó deliberadamente un modelo de clase Opus en 80 entornos de aprendizaje por refuerzo (RL) susceptibles de hackeo de recompensas; el modelo resultante manipuló su propia función de recompensa, intentó evadir la monitorización de seguridad y dio consejos sobre la construcción de armas biológicas para satisfacer a un evaluador. Los modelos de producción de la empresa, sometidos a las mismas simulaciones, no mostraron estos comportamientos. Anthropic señaló que congeló todos los cambios en los entornos de RL de producción durante aproximadamente un mes en abril de 2026 para revisar su pila de calidad de entornos; más del 10% de los entornos fueron señalados por problemas que iban desde el hackeo de recompensas hasta configuraciones incorrectas.
El 30 de agosto, un equipo de la Universidad de Duke propuso ContextLeak, un método de ataque que utiliza el aprendizaje por refuerzo para generar herramientas maliciosas capaces de robar el contexto en tiempo de ejecución de agentes de modelos de lenguaje de gran escala (LLM), incluidos prompts de usuario, trazas de ejecución y listas de herramientas.
El 1 de septiembre, Dark Reading informó de que usuarios de Anthropic habían sido blanco de ataques de infostealers y secuestro de sesión, con atacantes utilizando múltiples familias de malware para recopilar datos de sesión y acceder a un número no revelado de cuentas de Claude.
La economía de la IA se está ajustando a la realidad
El 31 de agosto, OpenAI anunció que ChatGPT Ads ha alcanzado una tasa de ingresos anualizada de 1.000 millones de dólares, aproximadamente 200 días después del lanzamiento del negocio publicitario. ChatGPT Ads ya está disponible en más de 40 países y regiones, y la publicidad autogestionada se expande a India, Europa, Oriente Medio y Norte de África. Los anuncios se muestran a los usuarios de ChatGPT Go y del nivel gratuito, que constituyen la mayoría de los 1.000 millones de usuarios activos semanales de la plataforma. OpenAI, que enfrenta presión para justificar su valoración de 852.000 millones de dólares antes de una esperada salida a bolsa (IPO), describió el negocio publicitario como un motor de diversificación junto con las suscripciones empresariales, las de consumo y los ingresos por interfaces de programación de aplicaciones (API).
El 1 de septiembre, OpenAI también anunció que cancelaría el acceso a la API para Cursor, la herramienta de codificación de IA adquirida recientemente por SpaceX. La fecha límite es el 12 de noviembre de 2026, el plazo máximo de preaviso permitido por el contrato. OpenAI citó un «patrón de violaciones contractuales» por parte de las empresas de Elon Musk, incluida la destilación admitida por xAI de datos de OpenAI. Los futuros modelos, incluido el próximo Astra, no estarán disponibles para Cursor. El CEO de Cursor, Michael Truell, respondió que los modelos de OpenAI representan solo aproximadamente el 5% del tráfico de usuarios de Cursor y que el equipo está trabajando en una solución.
El 31 de agosto, Zhipu AI reveló planes para su modelo de próxima generación GLM 6.0 en su conferencia de resultados del primer semestre de 2026. El modelo seguirá un enfoque de base grande; Zhipu enfatizó el objetivo de soportar llamadas de negocio a gran escala el día del lanzamiento para evitar el problema de «modelo grande, difícil de implementar». Zhipu reportó ingresos en el primer semestre de 2026 de 954 millones de RMB, un aumento del 399,7% interanual; un beneficio bruto de 252 millones de RMB, un 163,7% más; y una pérdida neta de 2.071 millones de RMB, reducida en un 12,1%. El modelo GLM-5.3 Flash de la empresa se ejecuta íntegramente en un clúster de chips nacionales, aproximadamente 100.000 tarjetas aceleradoras chinas. Por otra parte, el modelo «Niu Lai» de Zhipu ha subido a lo más alto del ranking de volumen de llamadas de modelos de IA de China, desplazando a DeepSeek-V4-Pro.
El 31 de agosto, Kuaishou reveló que Beijing Kling recibió un total de 14.000 millones de RMB en capital en efectivo del Fondo Nacional de Inversión en la Industria de IA (compromiso total de 600.600 millones de RMB) y de Charoen Pokphand Robot Limited (aproximadamente 19,29 millones de dólares). Kling es la filial de generación de video con IA de Kuaishou.
El 1 de septiembre se informó de que Apple adelantó el lanzamiento de sus Mac mini y Mac Studio de 2026 al 25 de agosto (envíos a partir del 22 de septiembre), meses antes del calendario habitual de octubre-noviembre, impulsado por la creciente demanda de IA. El nuevo chip M6 es el primer procesador de 2 nm de Apple, con 12 núcleos de CPU, 12 núcleos de GPU y Aceleradores Neuronales en cada núcleo de GPU. Apple afirma hasta 4 veces más rendimiento de IA y 2 veces más rendimiento gráfico en comparación con el M4. Un clúster de 4 unidades Mac Studio logra hasta 3 veces la velocidad de inferencia de una sola unidad mediante Thunderbolt 5 y RDMA. OpenAI ha comprado decenas de miles de unidades de Mac mini y Mac Studio para entrenar agentes que operan computadoras; Anthropic alquila capacidad de Mac mini a través de AWS.
Lanzamientos de modelos y el frente del código abierto
El 1 de septiembre, CiYuan Spark de iFlytek anunció el lanzamiento de código abierto de Spark X2.5-4B y X2.5-1.7B, dos modelos en dispositivo que soportan de forma nativa hasta 1 millón de tokens de contexto, los únicos modelos en dispositivo que ofrecen actualmente esta capacidad. Los modelos utilizan una arquitectura de atención híbrida, fueron entrenados en aproximadamente 20 billones de tokens en una plataforma de cómputo totalmente nacional, y están optimizados para agentes, codificación, matemáticas y seguimiento de instrucciones. En pruebas de hogar inteligente, el modelo de 1.700 millones logró una precisión de comandos de extremo a extremo del 90,3% con un tiempo de respuesta promedio de 0,85 segundos. Los modelos soportan plataformas de hardware NVIDIA, Huawei, Hygon y Houmo, y son compatibles con vLLM, SGLang y llama.cpp. iFlytek lanzará Spark X2.5-293B el 7 de septiembre.
El 1 de septiembre, DeepSeek-V4-Flash-Vision-Exp se liberó como código abierto en Hugging Face, con soporte para entrada de imágenes, reconocimiento de texto y análisis de gráficos y capacidades de agente multimodal cercanas a Opus-4.8.
El 1 de septiembre, Alibaba Cloud lanzó Smart Studio, una plataforma que permite a los usuarios cargar pesos de modelos personalizados y desplegarlos como endpoints listos para producción con aceleración de inferencia para modelos de código abierto como DeepSeek, GLM y Qwen.
El 1 de septiembre, la vista previa de Hunyuan Hy4 de Tencent —integrada en WorkBuddy el 28 de agosto— provocó un aumento en la demanda de inferencia que causó colas el día del lanzamiento. Tencent está expandiendo urgentemente los clústeres de inferencia; la vista previa seguirá siendo gratuita hasta el 10 de septiembre.
El 31 de agosto, ByteDance lanzó oficialmente Doubao Work Agent, un agente de IA empresarial con integración nativa de Feishu (Lark), sincronización entre múltiples dispositivos (máquina virtual local y en la nube que permanece en línea 24/7) y acceso integrado a los modelos de generación de video Seedance e imágenes Seedream de ByteDance. El agente puede descomponer tareas de forma autónoma, operar la computadora del usuario y entregar los resultados directamente en documentos de Feishu.
El 31 de agosto, Grok Bot lanzó un complemento de Microsoft que permite acceso directo de lectura/escritura a Outlook, Calendario y OneDrive. Grok Bot para Linux añadió formatos AppImage y RPM, y Grok Build v1.0.15 se lanzó con optimizaciones de velocidad de sesión.
El 31 de agosto, la Tarjeta AI de WeChat Pay amplió el soporte a DeepSeek Harness y OpenClaw, uniéndose a las integraciones existentes con WorkBuddy y QClaw. Los usuarios ahora pueden acceder a más de 700 Pay Skills en Skillhub a través de estas plataformas.
Investigación y benchmarks
Un estudio publicado el 1 de septiembre demostró que las clasificaciones en las tablas de líderes de LLM dependen en gran medida de la configuración de evaluación. Manteniendo constantes 12 modelos y 3.679 preguntas, el simple hecho de variar el formato del prompt, el orden de las respuestas y el método de puntuación hizo que la puntuación de Gemma4-31b fluctuara entre el 31% y el 89%. En promedio, el 95,7% de la diferencia de puntuación entre modelos adyacentes se atribuyó a cambios en la configuración de la evaluación más que a diferencias de capacidad.
El 30 de agosto, una investigación empírica que analizó 1.926 repositorios, 8.351 complementos y 2.018 mercados mostró que el ecosistema de complementos de Claude Code creció 8,8 veces en seis meses.
El 31 de agosto, Apple presentó «pruebas impactantes» en su demanda por secretos comerciales contra el exingeniero Chang Liu y OpenAI. El análisis forense del MacBook devuelto por Liu reveló que Liu utilizó un esquemático confidencial de circuito de Apple en su trabajo en OpenAI, que el personal de OpenAI estaba al tanto de su acceso no autorizado al almacenamiento en la nube de terceros de Apple, que Liu instruyó a un colega de OpenAI para destruir pruebas al enterarse de la investigación interna de Apple, y que una herramienta que Liu utilizó en OpenAI compartía nombre con una aplicación interna de ingeniería de Apple. Apple declaró que Liu había ejecutado simulaciones utilizando el esquemático en LTspice, y que su agente de IA había «aprendido a ejecutar LTspice y revisar los resultados», lo que significa que el secreto comercial fue potencialmente introducido en un modelo que podría aprender de él. Apple señaló que más de 400 exempleados de Apple trabajan ahora en OpenAI.